Code
x <- 2
typeof(x)
[1] "double"Code
mode(x)[1] "numeric"Code
class(x)[1] "numeric"Code
y <- 1L
typeof(y)
[1] "integer"Code
class(y)[1] "integer"typeof()、mode() 与 class() 的区别,理解底层存储类型与抽象类别的不同含义1 与 1L 的差异在现代科研中,数据就是研究对象。
无论是
最终都会变成 R中的对象(object)。
因此学习R语言的第一步就是理解:
数据在R中是如何被存储和组织的
简单来说:
数据 → 数据类型 → 数据结构 → 分析
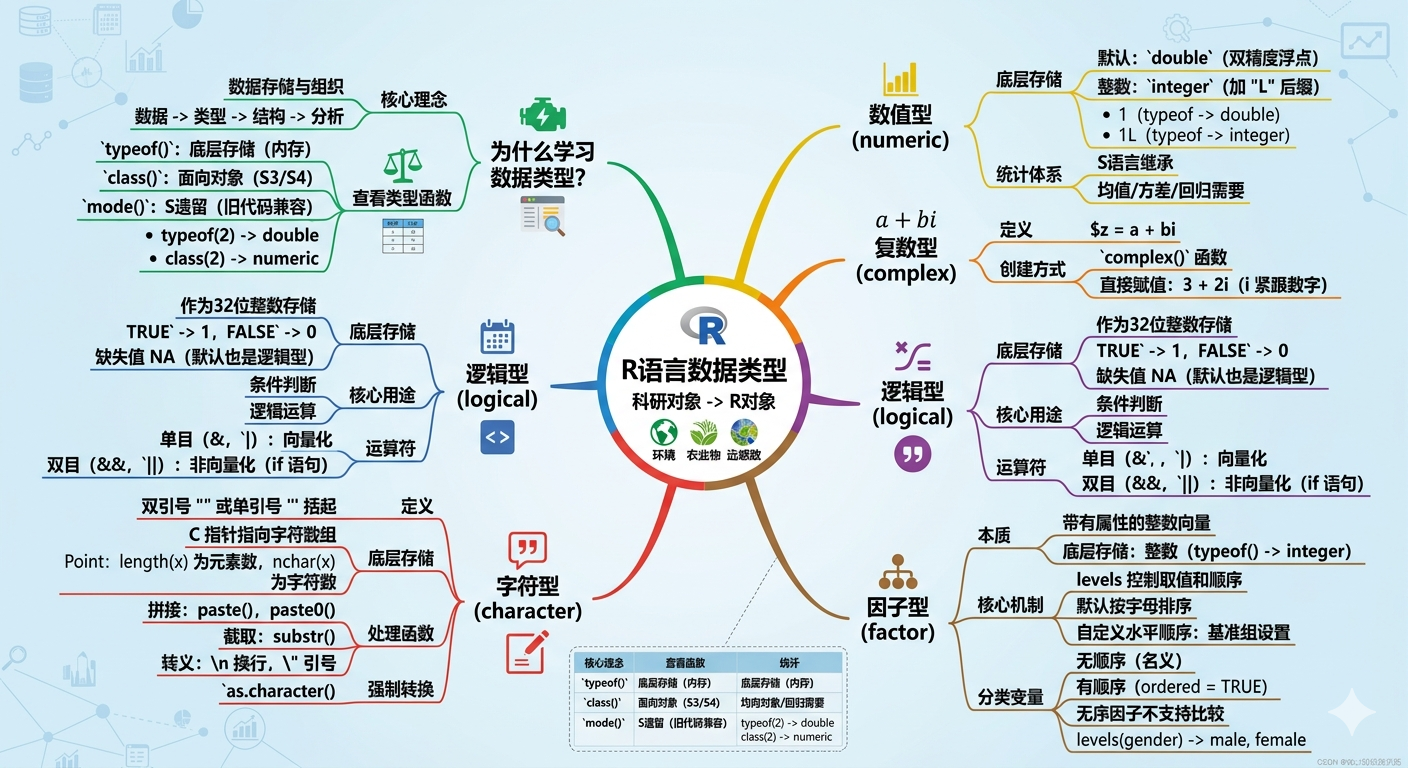
R的基础数据类型主要包括:
这些类型是 R语言一切数据结构的基础。
在 R 中,一个对象往往同时具有 底层存储类型(type) 和 抽象类别(class)。
typeof()、mode() 和 class() 三个函数分别从不同角度描述对象。
| 函数 | 主要功能 | 关注层面 | 典型用途 | 示例结果 |
|---|---|---|---|---|
typeof() |
查看对象在R内部的存储类型 | 底层实现 | 了解对象在内存中的数据类型 | typeof(2) → "double" |
mode() |
S语言遗留函数,表示对象的存储模式 | 历史兼容层 | 较少使用,主要用于兼容旧代码 | mode(2) → "numeric" |
class() |
查看对象的抽象类别 | 面向对象系统 | 决定函数调用的方法(S3/S4) | class(2) → "numeric" |
数值型是R中最常见的数据类型。
例如:
x <- 2
typeof(x)[1] "double"mode(x)[1] "numeric"class(x)[1] "numeric"y <- 1L
typeof(y)[1] "integer"class(y)[1] "integer"L 是 integer literal suffix(整数常量后缀)。
通常会看到:
x <- 1 的 typeof(x) 是 "double"y <- 1L 的 typeof(y) 是 "integer"这说明:
1 在 R 里默认按 双精度数值(double) 存储1L 才是 整数(integer)为什么 R 默认把 1 当作 double?
这是因为 R 继承自 S 语言的统计计算体系。
在统计分析中,大多数数值运算都需要浮点数,例如:
因此 R 统一把普通数字当作 double。
复数型是 R 语言中用于表示复数的数据类型。复数通常表示为 \(z = a + bi\) 的形式,其中 \(a\) 是实部,\(b\) 是虚部,\(i\) 是虚数单位(\(i^2 = -1\))。
在 R 中,复数必须显式定义。如果只输入实数,R 会将其视为数值型,除非通过特定函数或格式明确指定其为复数。
我们可以使用 complex() 函数来创建复数,或者直接使用虚数单位 i(注意:直接输入时,虚数单位 i 必须紧跟在数字后面,如 2i)。
# 方法一:使用 complex 函数构造
x <- 1
y <- 1
z <- complex(real = x, imaginary = y)
z
[1] 1+1i# 查看类型
typeof(z)[1] "complex"# 方法二:直接赋值(注意 'i' 的写法)
z2 <- 3 + 2i
z2 [1] 3+2i逻辑型是 R 语言中最基础的数据类型之一,主要用于表示真值。它只有两个有效取值:TRUE(真)和 FALSE(假)。此外,还有一个特殊的逻辑值 NA,用于表示缺失值。
在 R 语言中,逻辑型变量在底层实际上是作为32位整数存储的。虽然我们看到的是 TRUE 和 FALSE,但在内存中它们分别对应整数 1 和 0。我们可以通过 typeof() 和 class() 函数来验证这一点。
# 定义逻辑变量
x <- TRUE
y <- NA

# 查看底层存储类型
typeof(x)
[1] "logical"# 查看 NA 的类型
# 注意:R 中的 NA 默认是逻辑型 NA,但也存在 NA_integer_ 等其他类型
typeof(y)[1] "logical"# 验证逻辑值与数值的关系
as.numeric(TRUE)[1] 1as.numeric(FALSE)[1] 0从上面的代码可以看出: * typeof(x) 返回 "logical",表明其官方类型。 * as.numeric(TRUE) 返回 1,as.numeric(FALSE) 返回 0。这意味着在数学运算中,R 会自动将逻辑值强制转换为数值进行计算。
逻辑运算是对逻辑值进行操作的核心方式,主要包括“与”、“或”、“非”三种基本运算。R 语言提供了两套运算符:
&, |):向量化运算,对向量的每一个元素进行比较。&&, ||):非向量化运算,仅比较向量的第一个元素,常用于 if 条件判断。a <- TRUE
b <- FALSE
# 1. 逻辑与:只有两者都为 TRUE 时才返回 TRUE
a & b [1] FALSE# 2. 逻辑或:只要有一个为 TRUE 就返回 TRUE
a | b [1] TRUE# 3. 逻辑非:取反
!b [1] TRUE字符型用于存储文本数据(字符串)。在 R 中,字符型数据需要用双引号 "" 或单引号 '' 括起来。即便内容是数字,只要加上引号,它就被视为字符型。
R 中的字符型向量存储的是字符串。typeof() 返回 "character",这表示底层的 C 语言类型是指向字符数组的指针(在 R 内部通过 CHARSXP 和 STRING 指针管理)。
x <- "1"

# 查看底层存储类型
typeof(x)
[1] "character"# 查看面向对象的类
class(x)[1] "character"# 查看长度(向量中元素的个数)
length(x)[1] 1# 查看字符串的实际字符数
nchar(x)[1] 1注意区别: * length(x) 返回的是向量中元素的个数(这里 x 只有一个元素 “1”,所以返回 1)。 * nchar(x) 返回的是字符串内容本身的长度(“1” 只有一个字符,所以返回 1)。
R 提供了丰富的函数来处理字符型数据,主要包括拼接、截取、查找和替换。
使用 paste() 或 paste0() 函数。paste() 默认以空格分隔,paste0() 则无分隔符,效率更高。
id <- "001"
name <- "R Language"

# paste 自动转换类型并拼接
paste("ID:", id, "Name:", name)
[1] "ID: 001 Name: R Language"# paste0 紧密拼接
paste0(id, "_", name)[1] "001_R Language"使用 substr() 或 substring() 提取部分字符串。
text <- "Data Science"

# 从第 1 位到第 4 位截取
substr(text, start = 1, stop = 4)
[1] "Data"在字符串中,某些特殊字符需要使用反斜杠 \ 进行转义。
# \n 换行符
cat("Line 1\nLine 2")
Line 1
Line 2# \" 输出双引号本身
cat("He said, \"Hello World\".")He said, "Hello World".# \t 制表符
cat("Col1\tCol2")Col1 Col2字符型与其他类型(如数值型、逻辑型)之间经常需要相互转换。
强制转换为字符型 使用 as.character() 函数。
# 数值转字符
num_val <- 123.45
as.character(num_val)
[1] "123.45"# 逻辑转字符
as.character(TRUE) # 结果为 "TRUE"[1] "TRUE"因子型是 R 语言中特有的一种数据类型,用于处理分类数据(Categorical Data)。它本质上是一个带有属性(水平和类)的整数向量。因子在统计建模(如线性回归、方差分析)和数据可视化中非常重要,因为它能明确区分“名义变量”(无顺序,如性别)和“有序变量”(有顺序,如等级)。
虽然因子打印出来像字符,但 typeof() 揭示了它的真面目:它在底层是使用整数存储的。每个整数对应一个“水平”标签。
# Creating a vector
x <- c("female", "male", "male", "female")
print(x)
[1] "female" "male" "male" "female"# Converting the vector x into a factor
# named gender
gender <- factor(x, levels = c("male", "female"))
print(gender)[1] female male male female
Levels: male female# 查看底层存储类型:整数
typeof(gender)[1] "integer"# 查看面向对象的类
class(gender)[1] "factor"# 查看因子的水平
levels(gender)[1] "male" "female"代码解析: * typeof(gender) 返回 "integer",说明因子底层存储的是整数索引。 * levels(gender) 返回 c("male", "female")。在这个例子中,底层的整数映射关系为:1 -> “male”,2 -> “female”。 * 打印 gender 时显示的 Levels 列表清晰地展示了所有可能的取值。
因子的核心在于水平的控制 ,即levels 属性。它不仅定义了允许的取值,还定义了顺序。
默认情况下,水平按字母顺序排列。但在实际分析中,我们经常需要自定义顺序(例如:设置基准组)。
# 默认情况:按字母顺序,Female 在前
factor(c("High", "Low", "Medium"))
[1] High Low Medium
Levels: High Low Medium# 强制指定顺序:Low < Medium < High
# 这里的 levels 参数决定了整数映射:Low=1, Medium=2, High=3
factor(c("High", "Low", "Medium"),
levels = c("Low", "Medium", "High"))[1] High Low Medium
Levels: Low Medium High因子可以包含数据中尚未出现的水平,这在处理训练集和测试集不一致时非常有用。
# 数据中只有 "male" 和 "female",但我们预设 "unknown" 也是一个有效水平
gender_full <- factor(c("male", "female"), levels = c("male", "female", "unknown"))
print(gender_full)
[1] male female
Levels: male female unknown对于像“低、中、高”这样有内在顺序的分类数据,应使用 ordered = TRUE。这允许在因子上进行比较运算。
status <- factor(c("low", "high", "medium", "high"),
                 levels = c("low", "medium", "high"),
                 ordered = TRUE)
print(status)
[1] low high medium high
Levels: low < medium < high# 有序因子支持比较运算
status[1] < status[2] # low < high 返回 TRUE [1] TRUE无序因子不支持比较
gender[1] < gender[2] # 会报错 | 数据类型 | R表示方式 | typeof()结果 | 典型取值示例 | 主要用途 |
|---|---|---|---|---|
| 数值型 (numeric) | 普通数字 | double |
1 3.14 -5 |
存储连续数值,最常见的数据类型 |
| 整数型 (integer) | 数字后加 L |
integer |
1L 10L |
存储整数,常用于索引或计数 |
| 复数型 (complex) | a + bi 或 complex() |
complex |
3+2i |
表示复数,常见于数学和信号处理 |
| 逻辑型 (logical) | TRUE / FALSE |
logical |
TRUE FALSE NA |
条件判断、逻辑运算 |
| 字符型 (character) | 用引号 " " 或 ' ' |
character |
"R" "data" |
存储文本数据 |
| 因子型 (factor) | factor()函数 |
integer(底层) |
factor(c("male","female")) |
表示分类变量 |
请根据下面代码,填写表格并补充解释。
obj1 <- 25.6
obj2 <- 25L
obj3 <- "25.6"
obj4 <- factor(c("A", "B", "A"))
obj5 <- FALSE
obj6 <- 1 + 4i
请完成下表:
| 对象 | 值 | typeof() | class() | 所属数据类型 | 你的解释 |
|---|---|---|---|---|---|
| obj1 | |||||
| obj2 | |||||
| obj3 | |||||
| obj4 | |||||
| obj5 | |||||
| obj6 |