Code
mean(c(1,2,3))[1] 2| 学习模块 | 主要内容 | 学习重点 | 学习难点 |
|---|---|---|---|
| R 编程基础 | 常见语法问题与编程习惯 | 理解 R 的基本语法规则 | 避免符号与大小写错误 |
| 变量与赋值 | 变量概念与赋值方式 | 理解变量是对象的名称 | <- 与 = 的区别 |
| RStudio 环境 | RStudio 工作界面与快捷操作 | 熟悉基本工作流程 | 理解各窗口之间的关系 |
| 工作路径与项目 | 工作路径与 Project 的使用 | 使用相对路径管理数据 | 建立规范项目结构 |
| AI 辅助编程 | AI 在 R 编程中的辅助作用 | 合理使用 AI 提高效率 | 判断与验证 AI 生成代码 |
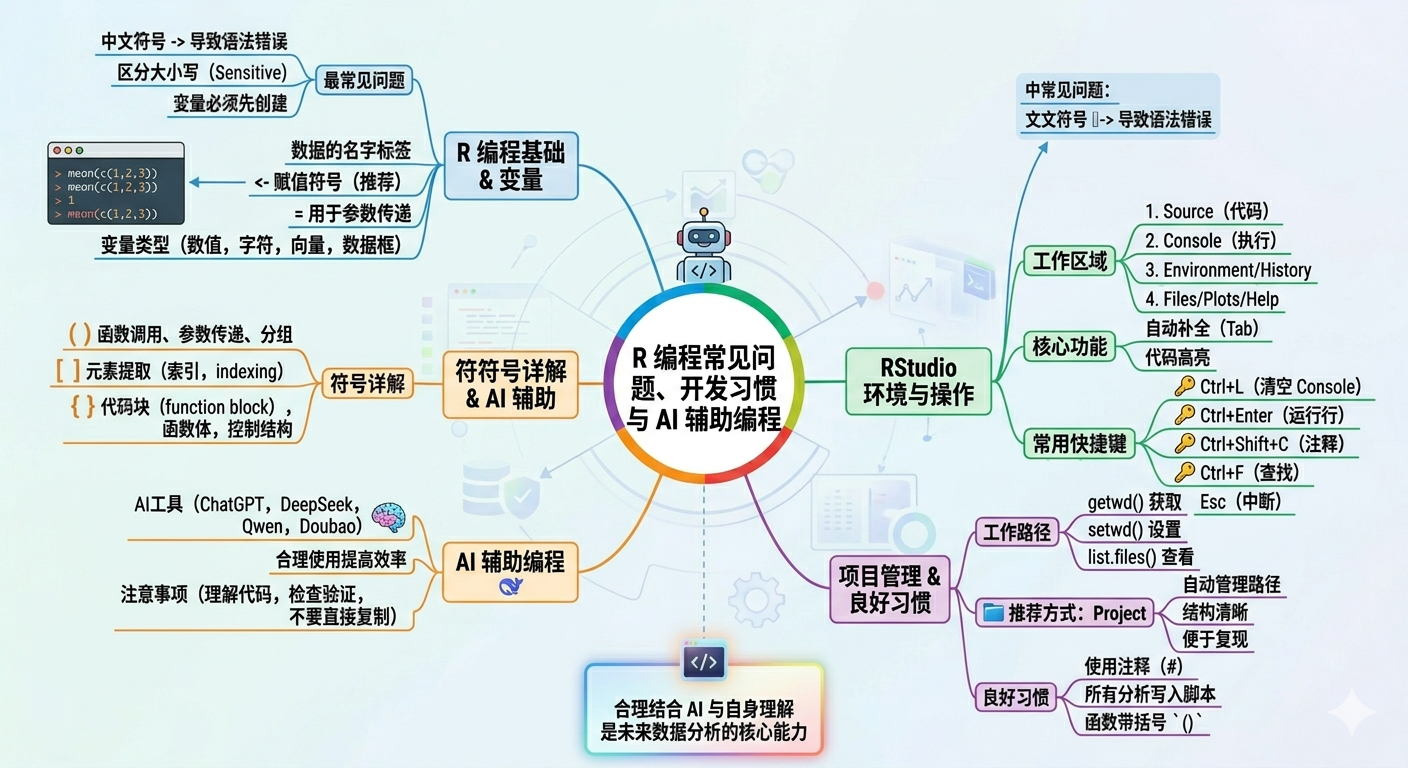
R 初学者最容易出现的问题通常不是统计方法,而是一些基础编程习惯问题。
在 R 中必须使用 英文符号,否则会导致语法错误。
常见错误包括:
(),“ ”正确示例:
mean(c(1,2,3))[1] 2错误示例(中文符号):
mean(c(1,2,3))R 是 大小写敏感语言。
例如:
mean(1:10)[1] 5.5与
Mean(1:10)含义不同,第二个会报错。
R 按顺序执行代码,因此变量必须先创建。
x <- 10
x + 5
[1] 15如果直接运行:
x + 5会产生错误,因为对象 x 尚未创建。
attach(mtcars)

lm.fit <- aov(mpg ~ factor(cyl))
summary(lm.fit)
Df Sum Sq Mean Sq F value Pr(>F)
factor(cyl) 2 824.8 412.4 39.7 4.98e-09 ***
Residuals 29 301.3 10.4
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1detach(mtcars)注意:
attach() 在现代 R 编程中已不推荐使用,建议使用 data= 参数。
推荐写法:
lm.fit <- aov(mpg ~ factor(cyl), data = mtcars)
summary(lm.fit)
Df Sum Sq Mean Sq F value Pr(>F)
factor(cyl) 2 824.8 412.4 39.7 4.98e-09 ***
Residuals 29 301.3 10.4
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1R 中最常见的赋值符号是:
<-例如:
lmfit <- lm(mpg ~ wt, data = mtcars)
lmfit
Call:
lm(formula = mpg ~ wt, data = mtcars)

Coefficients:
(Intercept)           wt
     37.285       -5.344
虽然 = 也可以赋值,但在 R 编程规范中,通常推荐使用 <-。<- 是 R 语言传统的赋值符号,来源于早期的 S 语言。
变量名(对象名) <- 值(对象)即“把右边的值赋给左边的对象”。在 R 中,<- 会被解释器识别为 赋值运算符(assignment operator)。
当 R 解析表达式时,会按照“从右向左”的顺序执行赋值操作。
例如:
x <- 3执行过程可以理解为:
x3 存入对象 x因此,赋值语句在 R 中本身也是一个表达式。
= 最初并不是用于对象赋值,而是用于 函数参数传递。
参数名 = 参数值在 R 语言中,变量(variable)是一个用于存储数据或对象的名称。
变量本质上是一个对象(object)的标识符,通过变量名可以访问和操作存储在内存中的数据。变量只是一个名字标签,用来指向数据或引用数据。
简单来说:
变量 = 数据的名字
当我们创建变量时,R 会在内存中存储数据,并用变量名指向该数据。
在 R 中,变量通常通过赋值运算符 <- 创建。
例如:
x <- 10这条语句的含义是:
10 存储在该对象中x 指向这个对象此时,变量 x 就代表数值 10。
我们可以查看变量:
x[1] 10变量不仅可以存储数字,还可以存储多种类型的数据。
a <- 5name <- "R language"v <- c(1, 2, 3, 4, 5)df <- data.frame(x = 1:3, y = c("A", "B", "C"))因此,在 R 中变量实际上是对象的名称。
当变量被创建时,数据会存储在 R 会话(session)的内存中。
例如:
x <- 100此时:
100 被存入内存x 指向该数据可以在 RStudio 的 Environment 面板 中看到变量 x。
big_data <- 1:1000000size <- object.size(big_data)
print(size)4000048 bytesformat(size, units = "MB")[1] "3.8 Mb"变量的值可以被重新赋值。
例如:
x <- 10
x <- 20
第二条语句会覆盖原来的值。
最终:
x[1] 20结果为:
20变量名称可以包含:
_但不能使用保留关键字。
例如:
##_abc <- 1某些关键字不能直接作为变量名,例如:
if <- 10如果必须使用,可以加反引号:
`if` <- 10但不建议这样做。
RStudio 是最常用的 R 开发环境。
主要优势包括:
RStudio 默认包含四个区域:
这种布局使得代码开发、调试和结果查看非常高效。
RStudio 提供强大的代码补全功能。
常用操作:
Tab 自动补全Up / Down 选择候选项Enter 接受补全Esc 取消补全示例:
输入:
mea按 Tab 可自动补全为:
mean()RStudio 会自动区分:
这可以显著提高代码可读性。
熟练掌握快捷键可以显著提高编程效率。
常见快捷键:
Ctrl + L 清空 ConsoleCtrl + Enter 运行当前代码行Ctrl + Shift + Enter 运行整段代码Ctrl + Shift + C 注释 / 取消注释Ctrl + F 查找Ctrl + Shift + F 全局查找Esc 中断当前运行RStudio 中查看完整快捷键:
Tools → Keyboard Shortcuts工作路径(Working Directory)是 R 读取和保存文件的默认位置。
getwd()setwd("C:/Users/username/Desktop")注意:
R 使用 / 作为路径分隔符。
list.files()现代 R 开发推荐使用 RStudio Project。
优点:
良好的代码习惯对于科研和项目开发非常重要。
使用 # 添加说明。
 #读取数据
data <- read.csv("data.csv")推荐原则:
例如:
getwd()而不是:
getwd()、[] 与 {}在 R 语言中,()、[] 和 {} 是三种非常常见的符号,它们分别用于 函数调用、参数传递、元素提取以及代码块控制。理解它们的作用,对于编写 R 程序非常重要。
():函数调用与参数() 最常见的用途是 调用函数并传递参数。
例如:
mean(c(1,2,3))这里:
mean 是函数名() 中放的是函数参数因此:
()用于 函数调用和参数传递。
函数通常可以有多个参数。
seq(from = 1, to = 10, by = 2)这里:
from、to、by 都是函数参数() 中定义了函数的输入信息() 还可以用于改变运算顺序。
(1 + 2) * 3如果没有括号:
1 + 2 * 3计算顺序会不同。
[]:元素提取(索引)[] 用于 从对象中提取元素,也叫 索引(indexing)。
x <- c(10,20,30,40)

x[2]
结果:
20表示提取第 2 个元素。
x[c(1,3)]结果:
10 30矩阵索引需要 行和列两个位置:
A <- matrix(1:9,3,3)

A[2,3]
表示:
第2行,第3列df <- data.frame(
id = 1:3,
score = c(80,90,85)
)
df[1,2]表示:
第1行,第2列{}:代码块(function block){} 用于表示 代码块(block),也可以理解为 一组需要连续执行的语句。
例如:
{
  x <- 1
  y <- 2
  x + y
}
R 会:
在函数定义中,{} 表示 函数体(function body)。
f <- function(x){
  y <- x + 1
  y * 2
}
这里:
function(x) 定义函数参数{} 中的代码是函数执行的内容x <- 5
if(x > 3){
print("x 大于 3")
}当条件满足时,{} 中的代码会被执行。
for(i in 1:3){
  print(i)
}
{} 表示循环体。
| 符号 | 作用 | 典型场景 |
|---|---|---|
() |
函数调用、参数传递、表达式分组 | mean(x) |
[] |
元素提取(索引) | x[2] |
{} |
代码块、函数体、控制结构 | if(){} |
简单记忆:
() → 函数与参数[] → 取数据{} → 一段代码近年来,AI 工具已经成为 R 编程的重要辅助工具。
合理使用 AI 可以显著提高学习效率。
优势:
适合用途:
DeepSeek 在代码生成方面表现非常强。
优势:
适合用途:
阿里推出的大模型,在国内使用非常稳定。
优势:
适合用途:
字节跳动推出的 AI 模型。
优势:
适合用途:
推荐使用方式:
示例提示词:
请用 R 语言使用 ggplot2 绘制散点图,
数据框名称为 df,
x 变量为 temperature,
y 变量为 yield,
并添加线性回归拟合线。
AI 会生成类似代码:
library(ggplot2)

ggplot(df, aes(temperature, yield)) +
 geom_point() +
geom_smooth(method = "lm")AI 可以辅助编程,但不能完全替代学习。
建议: